
Ważne rozróżnienie: badanie dotyczy oficjalnej funkcji ChatGPT Search dostępnej w serwisie ChatGPT. Nie testuje czatu działającego na czat-gpt.chat. Czat-gpt.chat jest niezależnym serwisem i nie jest oficjalną witryną, produktem ani częścią OpenAI. To badanie nie jest też testem pytań z fałszywymi założeniami.
ChatGPT Search może podać krótką odpowiedź i dołączyć link. Sam link nie dowodzi jednak, że odpowiedź jest poprawna, aktualna ani w pełni wsparta przez treść źródła. Dlatego oceniliśmy osobno sześć wymiarów: poprawność faktu, aktualność, możliwość otwarcia linku, zgodność źródła z twierdzeniem, jakość źródła i kompletność cytowania.
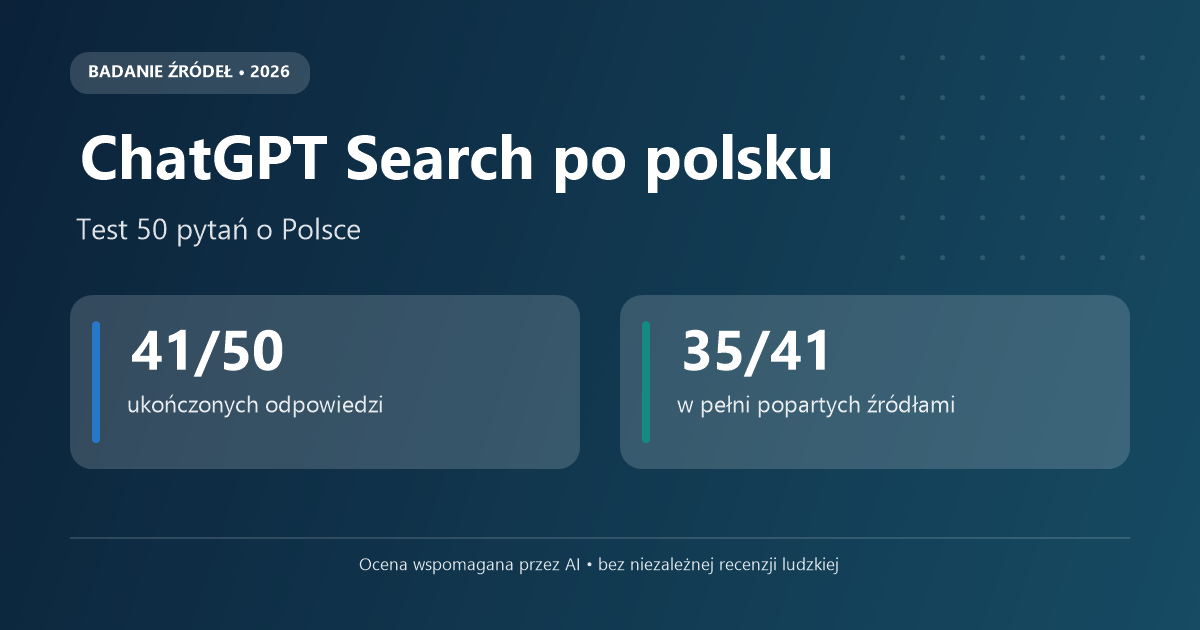
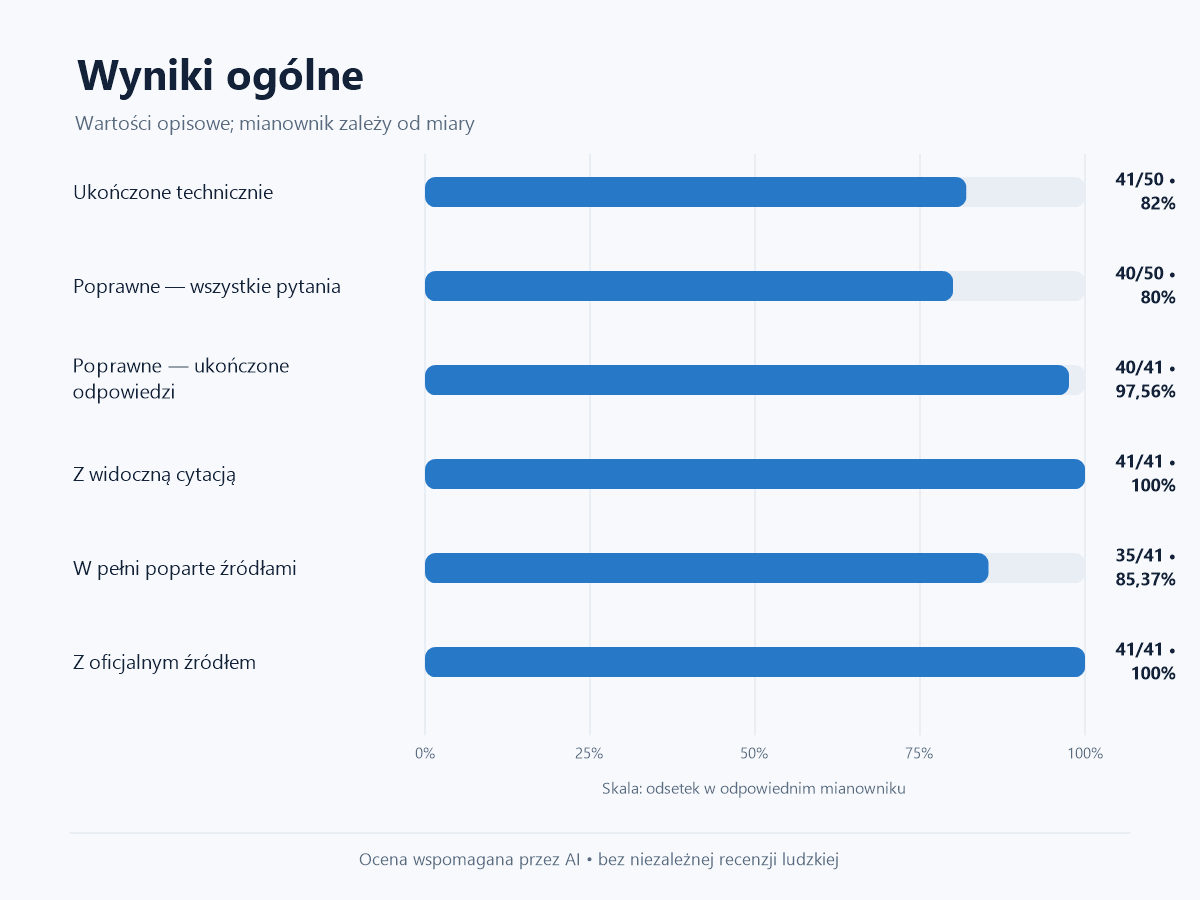
W celowo dobranym benchmarku 50 aktualnych pytań o Polsce uzyskaliśmy 41/50 ukończonych odpowiedzi merytorycznych. Wśród nich 40/41 odpowiedzi było w pełni poprawnych, wszystkie 41/41 zawierały uchwycone cytowanie i wszystkie 41/41 wykorzystywały co najmniej jedno kompetentne polskie źródło oficjalne lub pierwotne. Ścisłe kryterium „w pełni poparta” spełniło 35/41 odpowiedzi.
Pozostałych dziewięciu pytań nie zaliczyliśmy jako błędów wiedzy. Po jednej dozwolonej ponownej próbie nadal nie powstała finalna odpowiedź merytoryczna, dlatego mają status technical_exhausted, a ich komponenty A/F/R/E/Q/C są oznaczone jako NA.
Najważniejsze wyniki
| Miara | Wynik | Jak czytać |
|---|---|---|
| Ukończenie techniczne | 41/50 (82,0%) | Pytania z finalną odpowiedzią merytoryczną |
| A=2 — wszystkie pytania | 40/50 (80,0%) | Dziewięć technicznych NA pozostaje w mianowniku 50 |
| A=2 — ukończone odpowiedzi | 40/41 (97,56%) | Poprawność wśród odpowiedzi możliwych do oceny |
| Cytowanie obecne | 41/41 (100%) | Co najmniej jedno uchwycone cytowanie istotnego twierdzenia |
| Kompetentne źródło oficjalne lub pierwotne | 41/41 (100%) | Co najmniej jedno takie źródło w każdej ukończonej odpowiedzi |
| W pełni poparte | 35/41 (85,37%) | Wszystkie A/F/R/E/Q/C równe 2 |
Obecność cytowania i użycie źródła oficjalnego nie są tym samym co pełne wsparcie. Link może być obecny, ale niemożliwy do niezależnego otwarcia; źródło może potwierdzać rdzeń odpowiedzi, ale nie dodatkowy szczegół; odpowiedź może też cytować wcześniejszą wersję danych zamiast najnowszej.
Karta badania
| Przedmiot testu | Oficjalny ChatGPT Search w przeglądarce |
|---|---|
| Plan widoczny w ukończonych próbach | ChatGPT Pro |
| Widoczna etykieta modelu | GPT-5.6 Sol |
| Widoczny poziom wysiłku | Pro |
| Zestaw pytań | 50 pytań, 10 kategorii po 5 |
| Dobór | Celowy benchmark, nie próba losowa |
| Język promptów / interfejsu | Polski / arabski |
| Środowisko | Codex in-app browser na Windows; dokładnej wersji przeglądarki nie zapisano |
| Data głównej serii | 10 sierpnia 2026 r. czasu lokalnego środowiska; zapisy UTC: 11 sierpnia, 01:51–03:26 |
| Geolokalizacja | Nie rejestrowano geolokalizacji sieci; precyzyjnej lokalizacji urządzenia nie zweryfikowano |
| Tryb | Nowy Temporary Chat dla każdej próby; Search jawnie wybierany przed wysłaniem promptu; bez Deep Research |
| Protokół | Wersja 1.1, zamrożona przed pierwszym ocenianym promptem |
| Ocena | Ocena badawcza wspomagana przez AI; human_review_performed=false |
Widoczne etykiety planu, modelu i wysiłku opisują wyłącznie stan interfejsu podczas testu. Nie są deklaracją architektury backendu. W części awarii przed wysłaniem pytania interfejs nie załadował kontrolki modelu, więc nie uznawaliśmy tych etykiet za potwierdzone dla takiej nieudanej próby.
Co dokładnie testowaliśmy?
Testowaliśmy funkcję Search w oficjalnym ChatGPT. OpenAI opisuje ją jako tryb wyszukiwania informacji w sieci z cytowaniami w odpowiedzi i panelem Sources: ChatGPT Search — OpenAI Help Center. Nie używaliśmy Deep Research, które OpenAI opisuje jako odrębny tryb do wieloetapowych, pogłębionych zadań: Deep research in ChatGPT.
Każde pytanie dotyczyło jednego aktualnego, publicznie sprawdzalnego faktu o Polsce. Polecenie kończyło się tak samo: odpowiedzieć po polsku w maksymalnie trzech zdaniach i podać źródło. Nie prosiliśmy o poradę dla konkretnej osoby i nie wysyłaliśmy pytania uzupełniającego w tej samej rozmowie.
Wnioski odnoszą się wyłącznie do udokumentowanej serii: polskie prompty, arabski interfejs, plan ChatGPT Pro, widoczna etykieta GPT-5.6 Sol i wysiłek Pro, Temporary Chat, jawnie wybrany Search oraz data testu. Nie można ich automatycznie przenosić na API, inne plany, modele, języki, późniejsze wersje produktu ani użytkowników przebywających w Polsce. Geolokalizacji sieci nie zapisano.
Jak przygotowaliśmy 50 pytań?
Zestaw obejmuje 10 kategorii po pięć pytań:
- demografia i statystyka;
- gospodarka i finanse;
- konsumenci i usługi publiczne;
- prawo i administracja;
- cyfryzacja i cyberbezpieczeństwo;
- instytucje i wybory;
- zdrowie i bezpieczeństwo publiczne;
- edukacja i nauka;
- transport i infrastruktura;
- środowisko i geografia.
Dobór był celowy. To nie jest próba losowa ani reprezentatywna dla całej polskiej wiedzy, wszystkich zapytań czy polskich użytkowników. Każde pytanie otrzymało przed testem zamrożoną prawidłową odpowiedź, datę lub okres odniesienia, oficjalne źródło, datę dostępu i dokładny lokalizator — na przykład stronę PDF, tabelę, artykuł ustawy albo sekcję witryny.
Źródłami referencyjnymi były akty prawne i urzędowe bazy, GUS, PKW, ministerstwa, urzędy i inne instytucje pierwotne właściwe dla danego faktu. Źródło referencyjne służyło do sprawdzenia odpowiedzi; nie „naprawiało” cytowania podanego przez ChatGPT Search.
Jak przebiegała każda próba?
- Otwarcie nowego Temporary Chat.
- Potwierdzenie pustej rozmowy oraz widocznych ustawień, gdy interfejs zdążył je załadować.
- Jawne wybranie Search.
- Wysłanie jednego zamrożonego pytania po polsku.
- Oczekiwanie na widoczny sygnał zakończenia bez doprecyzowania i bez regenerowania odpowiedzi ze względu na jej jakość.
- Zapis pełnego tekstu, HTML kontenera odpowiedzi, cytowań, adresów i metadanych próby.
- Jedna ponowna próba wyłącznie po zdefiniowanym błędzie technicznym, z zachowaniem nieudanej próby w surowym logu.
Błąd techniczny oznaczał udokumentowany problem ładowania strony, wysyłania, interfejsu, limitu lub brak finalnego sygnału zakończenia w ciągu 90 sekund. Błędna, słaba, zaskakująca albo niepełna odpowiedź merytoryczna nie była błędem technicznym i nie mogła zostać wygenerowana ponownie.
Seria 50 pytań utworzyła 64 rekordy prób: 50 pierwszych prób i 14 dozwolonych ponowień. W pięciu pytaniach ponowienie zakończyło się odpowiedzią merytoryczną. W dziewięciu także druga próba zakończyła się technicznie.
Dziewięć przypadków technical_exhausted
| Run / ID | Kategoria | Obserwacja po dozwolonym ponowieniu |
|---|---|---|
| 10 / B09 | Cyfryzacja i cyberbezpieczeństwo | Dwukrotnie nie dołączył się webview przed wysłaniem pytania |
| 20 / B06 | Cyfryzacja i cyberbezpieczeństwo | Dwukrotnie brak finalnego sygnału w 90 s; częściowy strumień wykluczono |
| 28 / C05 | Zdrowie i bezpieczeństwo publiczne | Dwukrotnie brak finalnego sygnału w 90 s |
| 38 / B10 | Cyfryzacja i cyberbezpieczeństwo | Najpierw brak zakończenia strumienia, potem brak kontrolki modelu |
| 39 / C12 | Transport i infrastruktura | Najpierw brak zakończenia strumienia, potem brak kontrolki modelu |
| 40 / C17 | Środowisko i geografia | Dwukrotnie brak finalnego sygnału w 90 s |
| 41 / A02 | Demografia i statystyka | Najpierw brak zakończenia strumienia, potem brak kontrolki modelu |
| 46 / A11 | Konsumenci i usługi publiczne | Dwukrotnie nie załadowała się kontrolka modelu |
| 47 / C11 | Transport i infrastruktura | Dwukrotnie nie załadowała się kontrolka modelu |
Te przypadki mierzą niezawodność ukończenia w opisanym środowisku. Nie dostarczyły treści do oceny merytorycznej, dlatego nie są odpowiedziami błędnymi i nie otrzymują A=0. Wszystkie sześć komponentów ma w nich NA.
Jak ocenialiśmy odpowiedzi i cytowania?
| Kod | Wymiar | Wynik 2 oznacza |
|---|---|---|
| A | Poprawność | Wszystkie materialne twierdzenia są zgodne z zamrożonym faktem |
| F | Aktualność | Odpowiedź podaje najnowszą właściwą wartość lub poprawny okres |
| R | Rozwiązanie linku | Każda materialna cytacja prowadzi do dostępnego, zamierzonego źródła |
| E | Zgodność źródła z twierdzeniem | Uchwycone źródło bezpośrednio wspiera każde materialne twierdzenie |
| Q | Jakość źródła | Użyto kompetentnego polskiego źródła oficjalnego lub pierwotnego |
| C | Kompletność cytowań | Każde materialne twierdzenie ma jednoznacznie przypisane cytowanie |
Każdy komponent ma skalę 0–2 albo NA w ściśle opisanej sytuacji. Suma 0–12 jest wyłącznie opisowa, a nie zwalidowaną skalą psychometryczną. Etykieta „w pełni poparta” wymaga sześciu dwójek jednocześnie.
Ocena wspomagana przez AI
Wstępna ocena była źródłowo sprawdzana bez udziału człowieka. Do dodatkowej oceny wybrano 14 przypadków: siedem wstępnie oznaczonych oraz siedem z deterministycznej, 20-procentowej próby audytowej przypadków nieoznaczonych. Każdy z tych 14 przypadków otrzymał dwie niezależne oceny AI i końcową syntezę AI opartą na zamrożonych regułach i źródłach. Nie wysyłano ponownie żadnego badanego promptu.
Nie wykonano niezależnej recenzji polskojęzycznego człowieka, językoznawcy ani recenzji akademickiej: human_review_performed=false. Identyfikatora backendowego modelu użytego do arbitrażu nie zapisano; zapisano system, reguły, daty, źródła i decyzje. Końcowa synteza zmieniła komponenty tylko w B12: wstępne R=0 i E=1 zastąpiono NA, ponieważ bramka weryfikacyjna nie dowodzi uszkodzenia linku, a dokładnej treści cytowanego dokumentu nie udało się niezależnie odczytać.
Rozkład komponentów
| Komponent | 0 | 1 | 2 | NA | Mianownik | Udział 2 |
|---|---|---|---|---|---|---|
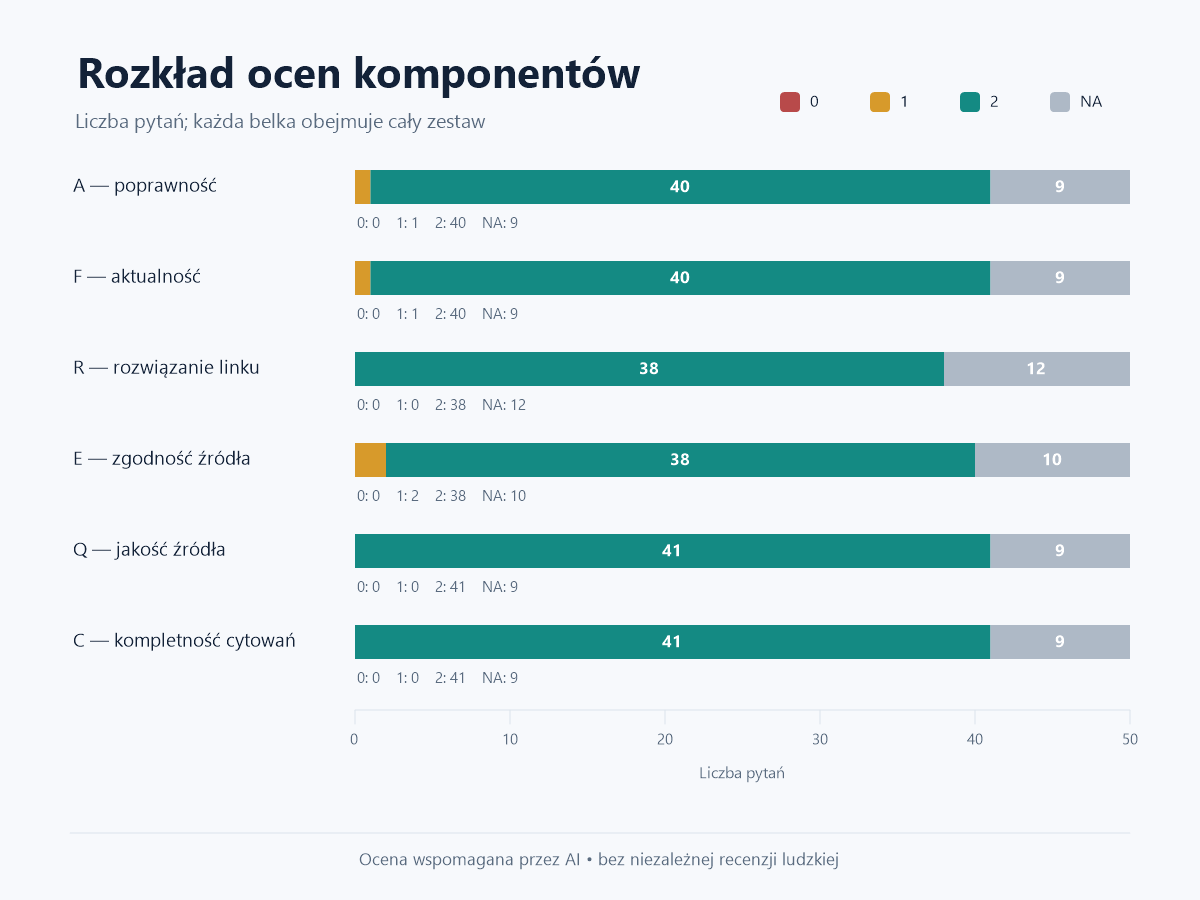
| A — poprawność | 0 | 1 | 40 | 9 | 41 | 97,56% |
| F — aktualność | 0 | 1 | 40 | 9 | 41 | 97,56% |
| R — rozwiązanie linku | 0 | 0 | 38 | 12 | 38 | 100% |
| E — wsparcie twierdzenia | 0 | 2 | 38 | 10 | 40 | 95,0% |
| Q — jakość źródła | 0 | 0 | 41 | 9 | 41 | 100% |
| C — kompletność cytowania | 0 | 0 | 41 | 9 | 41 | 100% |
Dziewięć NA w A, F, Q i C to wyłącznie pytania technical_exhausted. W R są dodatkowo trzy ukończone odpowiedzi, których dokładnych linków nie dało się uczciwie sklasyfikować z powodu bramki weryfikacyjnej lub ograniczenia dostępu. W E dochodzi jeden ukończony przypadek, w którym treści dokładnie cytowanego dokumentu nie udało się ocenić ani przez równoważną kopię.
Wyniki według kategorii
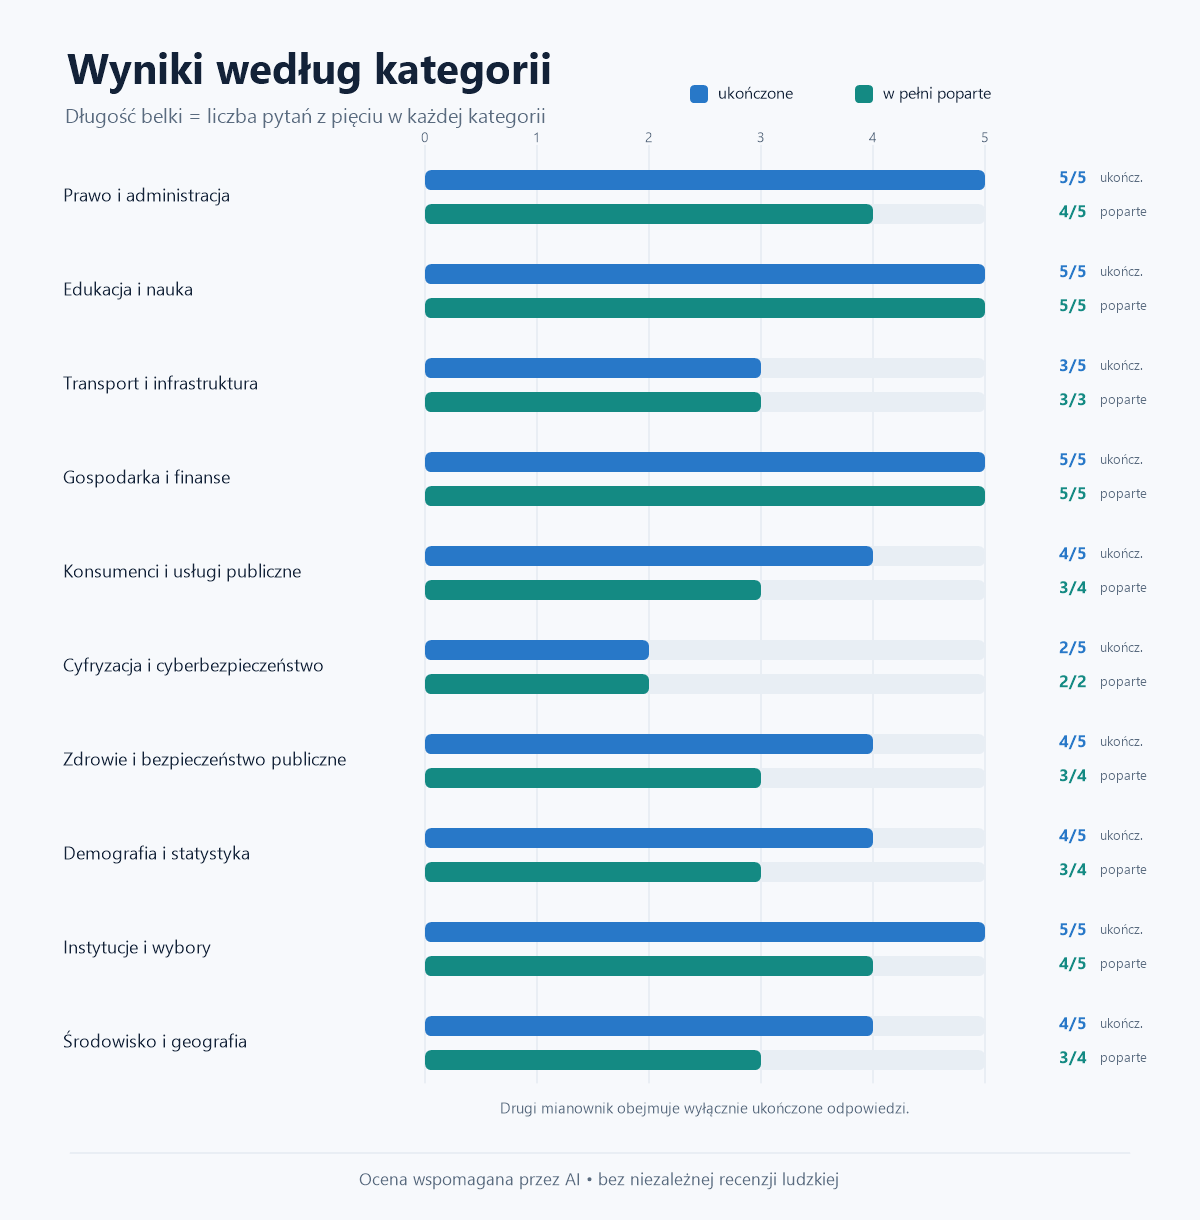
| Kategoria | Ukończone / 5 | A=2 | F=2 | E=2 | Q=2 | W pełni poparte |
|---|---|---|---|---|---|---|
| Demografia i statystyka | 4/5 | 3/4 | 3/4 | 4/4 | 4/4 | 3/4 |
| Gospodarka i finanse | 5/5 | 5/5 | 5/5 | 5/5 | 5/5 | 5/5 |
| Konsumenci i usługi publiczne | 4/5 | 4/4 | 4/4 | 4/4 | 4/4 | 3/4 |
| Prawo i administracja | 5/5 | 5/5 | 5/5 | 5/5 | 5/5 | 4/5 |
| Cyfryzacja i cyberbezpieczeństwo | 2/5 | 2/2 | 2/2 | 2/2 | 2/2 | 2/2 |
| Instytucje i wybory | 5/5 | 5/5 | 5/5 | 4/4 | 5/5 | 4/5 |
| Zdrowie i bezpieczeństwo publiczne | 4/5 | 4/4 | 4/4 | 3/4 | 4/4 | 3/4 |
| Edukacja i nauka | 5/5 | 5/5 | 5/5 | 5/5 | 5/5 | 5/5 |
| Transport i infrastruktura | 3/5 | 3/3 | 3/3 | 3/3 | 3/3 | 3/3 |
| Środowisko i geografia | 4/5 | 4/4 | 4/4 | 3/4 | 4/4 | 3/4 |
Mianowniki A/F/E/Q obejmują wyłącznie odpowiedzi, dla których dany komponent był liczbowo ocenialny. Różnic między kategoriami nie należy traktować jako stabilnego rankingu: każda grupa zawiera tylko pięć pytań, a techniczne NA silnie wpływają na małe próby.
Czy poprawna odpowiedź oznacza dobre wsparcie?
| Typ przypadku | Liczba | Interpretacja |
|---|---|---|
| Poprawna i w pełni poparta | 35 | A=2 i wszystkie pozostałe komponenty równe 2 |
| Poprawna, ale nie w pełni poparta | 5 | A=2, lecz co najmniej jeden z R/E/F/Q/C jest niższy od 2 lub NA |
| Nie w pełni poprawna mimo cytowania | 1 | A=1; rdzeń był poprawny, ale dodatkowy materialny szczegół był nieaktualny |
| Brak odpowiedzi merytorycznej po ponowieniu | 9 | technical_exhausted; brak danych do oceny wiedzy |
Jedyna odpowiedź z A=1 to A05. Podała poprawną wartość ogólną 72, ale dodała wcześniejsze rozbicie 30+42; późniejsza końcowa publikacja GUS podawała 30+41. Cytowana strona rzeczywiście wspierała własne wcześniejsze dane, dlatego E pozostało równe 2, natomiast A i F otrzymały 1.
Dwie odpowiedzi miały E=1. W C18 cytowana strona potwierdzała Rysy i 2499 m n.p.m., ale nie wszystkie dodane kwalifikatory o konkretnym wierzchołku i granicy. W C04 cytowana strona potwierdzała siedem dni ważności e-recepty na antybiotyk, lecz nie łączyła wprost z antybiotykiem dodanej klauzuli o późniejszej „dacie realizacji od”.
Cztery przykłady wybrane według jawnej reguły
Reguła redakcyjna: wybieramy rekord o najniższym run_order w czterech klasach — w pełni poparty, poprawny z nierozstrzygniętym dostępem do linku, A<2 oraz E=1. Nie wybieramy przykładów według atrakcyjności tematu.
B04, run 1 — odpowiedź poprawna i w pełni poparta
Pytanie dotyczyło wymiaru urlopu przy stażu poniżej 10 lat i od 10 lat. Odpowiedź podała 20 i 26 dni oraz połączyła je z oficjalną stroną Ministerstwa Rodziny, Pracy i Polityki Społecznej. Wynik: A2/F2/R2/E2/Q2/C2.
A14, run 6 — treść poprawna, ale R pozostaje NA
Odpowiedź prawidłowo podała 30 dni i maksymalnie 60 dni na rozpatrzenie reklamacji. Dokładny link ISAP zatrzymał niezależne otwarcie na weryfikacji człowieka, więc nie uznaliśmy go ani za działający, ani za uszkodzony. Treść tego samego aktu była dostępna w ELI i wspierała twierdzenie. Wynik: A2/F2/R-NA/E2/Q2/C2.
A05, run 13 — poprawny rdzeń i nieaktualny szczegół
Odpowiedź podała właściwe 72 osoby w wieku nieprodukcyjnym na 100 osób w wieku produkcyjnym, ale dodała rozbicie 30+42 z wcześniejszego szacunku GUS. Późniejsza publikacja końcowa wskazywała 30+41. Wynik: A1/F1/R2/E2/Q2/C2.
C18, run 30 — poprawna treść, częściowe wsparcie
Odpowiedź prawidłowo wskazała Rysy, 2499 m n.p.m. i konkretny graniczny wierzchołek. Uchwycona strona RDOŚ w Krakowie potwierdzała Rysy, wysokość i status najwyższego punktu, ale nie wypowiadała wszystkich dodanych kwalifikatorów. Wynik: A2/F2/R2/E1/Q2/C2.
Co wyniki znaczą dla użytkownika?
W tym benchmarku ukończone odpowiedzi były zazwyczaj poprawne i zawsze zawierały źródło oficjalne. Nadal warto otwierać link, ponieważ obecność cytowania nie gwarantuje pełnego wsparcia każdego szczegółu. OpenAI samo zaleca weryfikowanie ważnych informacji i ostrzega, że ChatGPT może podawać błędne fakty lub cytowania: Does ChatGPT tell the truth?.
- Otwórz cytowany link.
- Znajdź dokładną liczbę, datę, nazwę albo przepis użyty w odpowiedzi.
- Sprawdź datę publikacji, aktualizacji i okres obowiązywania.
- Upewnij się, że źródło wspiera całe zdanie, nie tylko jego rdzeń.
- W sprawach prawnych, zdrowotnych, finansowych i urzędowych przejdź do źródła pierwotnego.
Szerszą procedurę opisuje nasz praktyczny proces weryfikowania źródeł w researchu.
Czego badanie nie dowodzi?
- Benchmark 50 pytań dobrano celowo; nie reprezentuje wszystkich zapytań ani całej polskiej wiedzy.
- Każda kategoria ma tylko pięć pytań.
- Dziewięć
technical_exhaustedopisuje brak ukończenia w tej serii, nie błędną wiedzę. - Wyniki dotyczą tylko udokumentowanej konfiguracji i daty testu.
- Prompty były po polsku, ale interfejs po arabsku. Geolokalizacji sieci nie zapisano, więc nie wolno opisywać serii jako wykonanej z Polski.
- Pojedyncza odpowiedź może nie odtworzyć się identycznie.
- Deep Research nie był częścią testu.
- Ocena była wspomagana przez AI; niezależnej recenzji ludzkiej ani akademickiej nie wykonano.
- Badanie nie porównuje równolegle ChatGPT Search z Google ani Perplexity.
- Badanie nie ocenia czatu działającego na czat-gpt.chat.
- Badanie nie sprawdza reakcji na fałszywe założenia.
Pobierz dane i odtwórz analizę
Publiczny pakiet został zredagowany z prywatnych identyfikatorów i surowego HTML. Przed utworzeniem tej wersji draftu każdy poniższy adres zwrócił HTTP 200 z oczekiwanym typem treści i rozmiarem, a pobrany plik był identyczny z lokalną wersją według SHA-256.
- Pobierz pełny pakiet badania ZIP — metodologia, zamrożone pytania, znormalizowane odpowiedzi, kontrole cytowań, końcowe oceny, analiza, dziennik przebiegu i manifest.
- Pobierz 50 zamrożonych pytań i fakty referencyjne CSV.
- Pobierz znormalizowane odpowiedzi CSV — bez surowego HTML i prywatnych identyfikatorów.
- Pobierz końcowe oceny A/F/R/E/Q/C CSV.
- SHA-256 pakietu ZIP:
8d8988ad337bb56e9794deeee4e50ea0af0c9c44e98cecc406c57ce75b62a724
Aby odtworzyć analizę, zweryfikuj SHA-256 pakietu, sprawdź pytania i fakty referencyjne, połącz odpowiedzi z kontrolą cytowań i wynikami po question_id, przelicz miary według protokołu 1.1 i porównaj liczniki z tabelami artykułu.
Powiązane materiały o odrębnej intencji
- Osobny test 100 pytań z fałszywymi założeniami bada, czy ChatGPT rozpoznaje błędną przesłankę — nie jakość cytowań w Search.
- Jak działa ChatGPT i czym różni się od Google jest ogólnym wyjaśnieniem produktu, a nie benchmarkiem źródeł.
- Praktyczny proces weryfikowania źródeł w researchu pokazuje sposób pracy użytkownika, a nie ocenę jednej wersji produktu.
- Porównanie ChatGPT i Perplexity pomaga wybrać narzędzie, ale nie jest równoległym testem tych samych 50 pytań.
Niezależność i sposób oceny
Badanie przygotowano dla niezależnego serwisu czat-gpt.chat. Serwis nie jest częścią OpenAI. Oficjalna dokumentacja OpenAI służy wyłącznie opisaniu funkcji i ograniczeń produktu; nie zastępuje danych empirycznych.
Ocena i synteza były wspomagane przez AI. human_review_performed=false. Nie wykonano niezależnej recenzji polskojęzycznego człowieka ani recenzji akademickiej. Publiczne dane i grafiki zostały zredagowane z prywatnych identyfikatorów, a schema Dataset wskazuje wyłącznie pliki zweryfikowane technicznie.